
Betrouwbare antwoorden
De assistent is op zijn scherpst in een kort, gericht gesprek over één onderwerp. Hoe langer en voller een chat wordt — veel vragen, veel documenten, meerdere onderwerpen door elkaar — hoe meer de assistent tegelijk moet overzien. Op een gegeven moment kan hij daardoor details door elkaar halen of een passage “aanvullen” die er niet letterlijk staat. Dit is geen eigenaardigheid van Prudai: het geldt voor alle huidige AI-modellen en is meetbaar — hoe langer het gesprek, hoe groter de kans op zulke fouten.
Het goede nieuws: je hebt dit grotendeels zelf in de hand.
Start een nieuwe chat per onderwerp
Section titled “Start een nieuwe chat per onderwerp”Dit is verreweg het effectiefst. Begin een nieuwe chat voor elk nieuw onderwerp of dossieronderdeel. Een korte, gefocuste chat houdt de assistent verankerd aan precies de stukken die er voor díe vraag toe doen — en juist dat voorkomt dat hij bronnen door elkaar gaat halen.
Vuistregels:
- Nieuw onderwerp? Nieuwe chat. Ga niet in dezelfde chat door van de aansprakelijkheidsvraag naar de proceskosten naar de dagvaarding.
- Houd het aantal documenten per chat gericht — alleen wat voor die vraag relevant is, niet je hele dossier in één doorlopend gesprek.
- Merk je dat een chat “moe” wordt (antwoorden worden vager, of de assistent verwijst naar iets dat je niet herkent)? Begin opnieuw in een verse chat. Je verliest niets: je documenten en je dossier blijven gewoon staan.
Het product waarschuwt je zelf
Section titled “Het product waarschuwt je zelf”Je hoeft dit niet alleen op gevoel te doen: de chat zegt het wanneer een gesprek te vol wordt.
Meldingen die oplopen. Naarmate een gesprek langer wordt, verandert de melding mee:
- “Dit gesprek wordt lang”: bij lange gesprekken kan de kwaliteit van de antwoorden geleidelijk afnemen.
- “Dit gesprek is erg lang”: we raden aan een nieuw gesprek te starten.
- “Dit gesprek is zeer lang”: de kwaliteit neemt waarschijnlijk merkbaar af; we raden sterk aan opnieuw te beginnen.
- “Dit gesprek nadert de limiet”: binnenkort worden oudere berichten automatisch samengevat en kan er detail verloren gaan.
Een blijvende melding in de chat. Naast die tijdelijke meldingen kan er een kaartje in het gesprek blijven staan, ook nadat je de pagina herlaadt. Het heeft twee knoppen: Start een gefocust gesprek en Hier verdergaan. Hoort het gesprek bij een dossier, dan gaat dat dossier mee naar het nieuwe gesprek.
De kop van het kaartje zegt wat er aan de hand is:
- “Dit gesprek wordt lang”: het gesprek heeft veel berichten.
- “Dit gesprek bevat veel stukken”: de lengte zit in lange teksten in het gesprek zelf, zoals tekst die je plakt en lange antwoorden van de assistent, ook als er nog weinig berichten zijn. Documenten die je bijvoegt en bronnen die de assistent in eerdere beurten opzocht, tellen niet mee.
- “Dit gesprek nadert de limiet”: de assistent gaat binnenkort oudere berichten samenvatten.
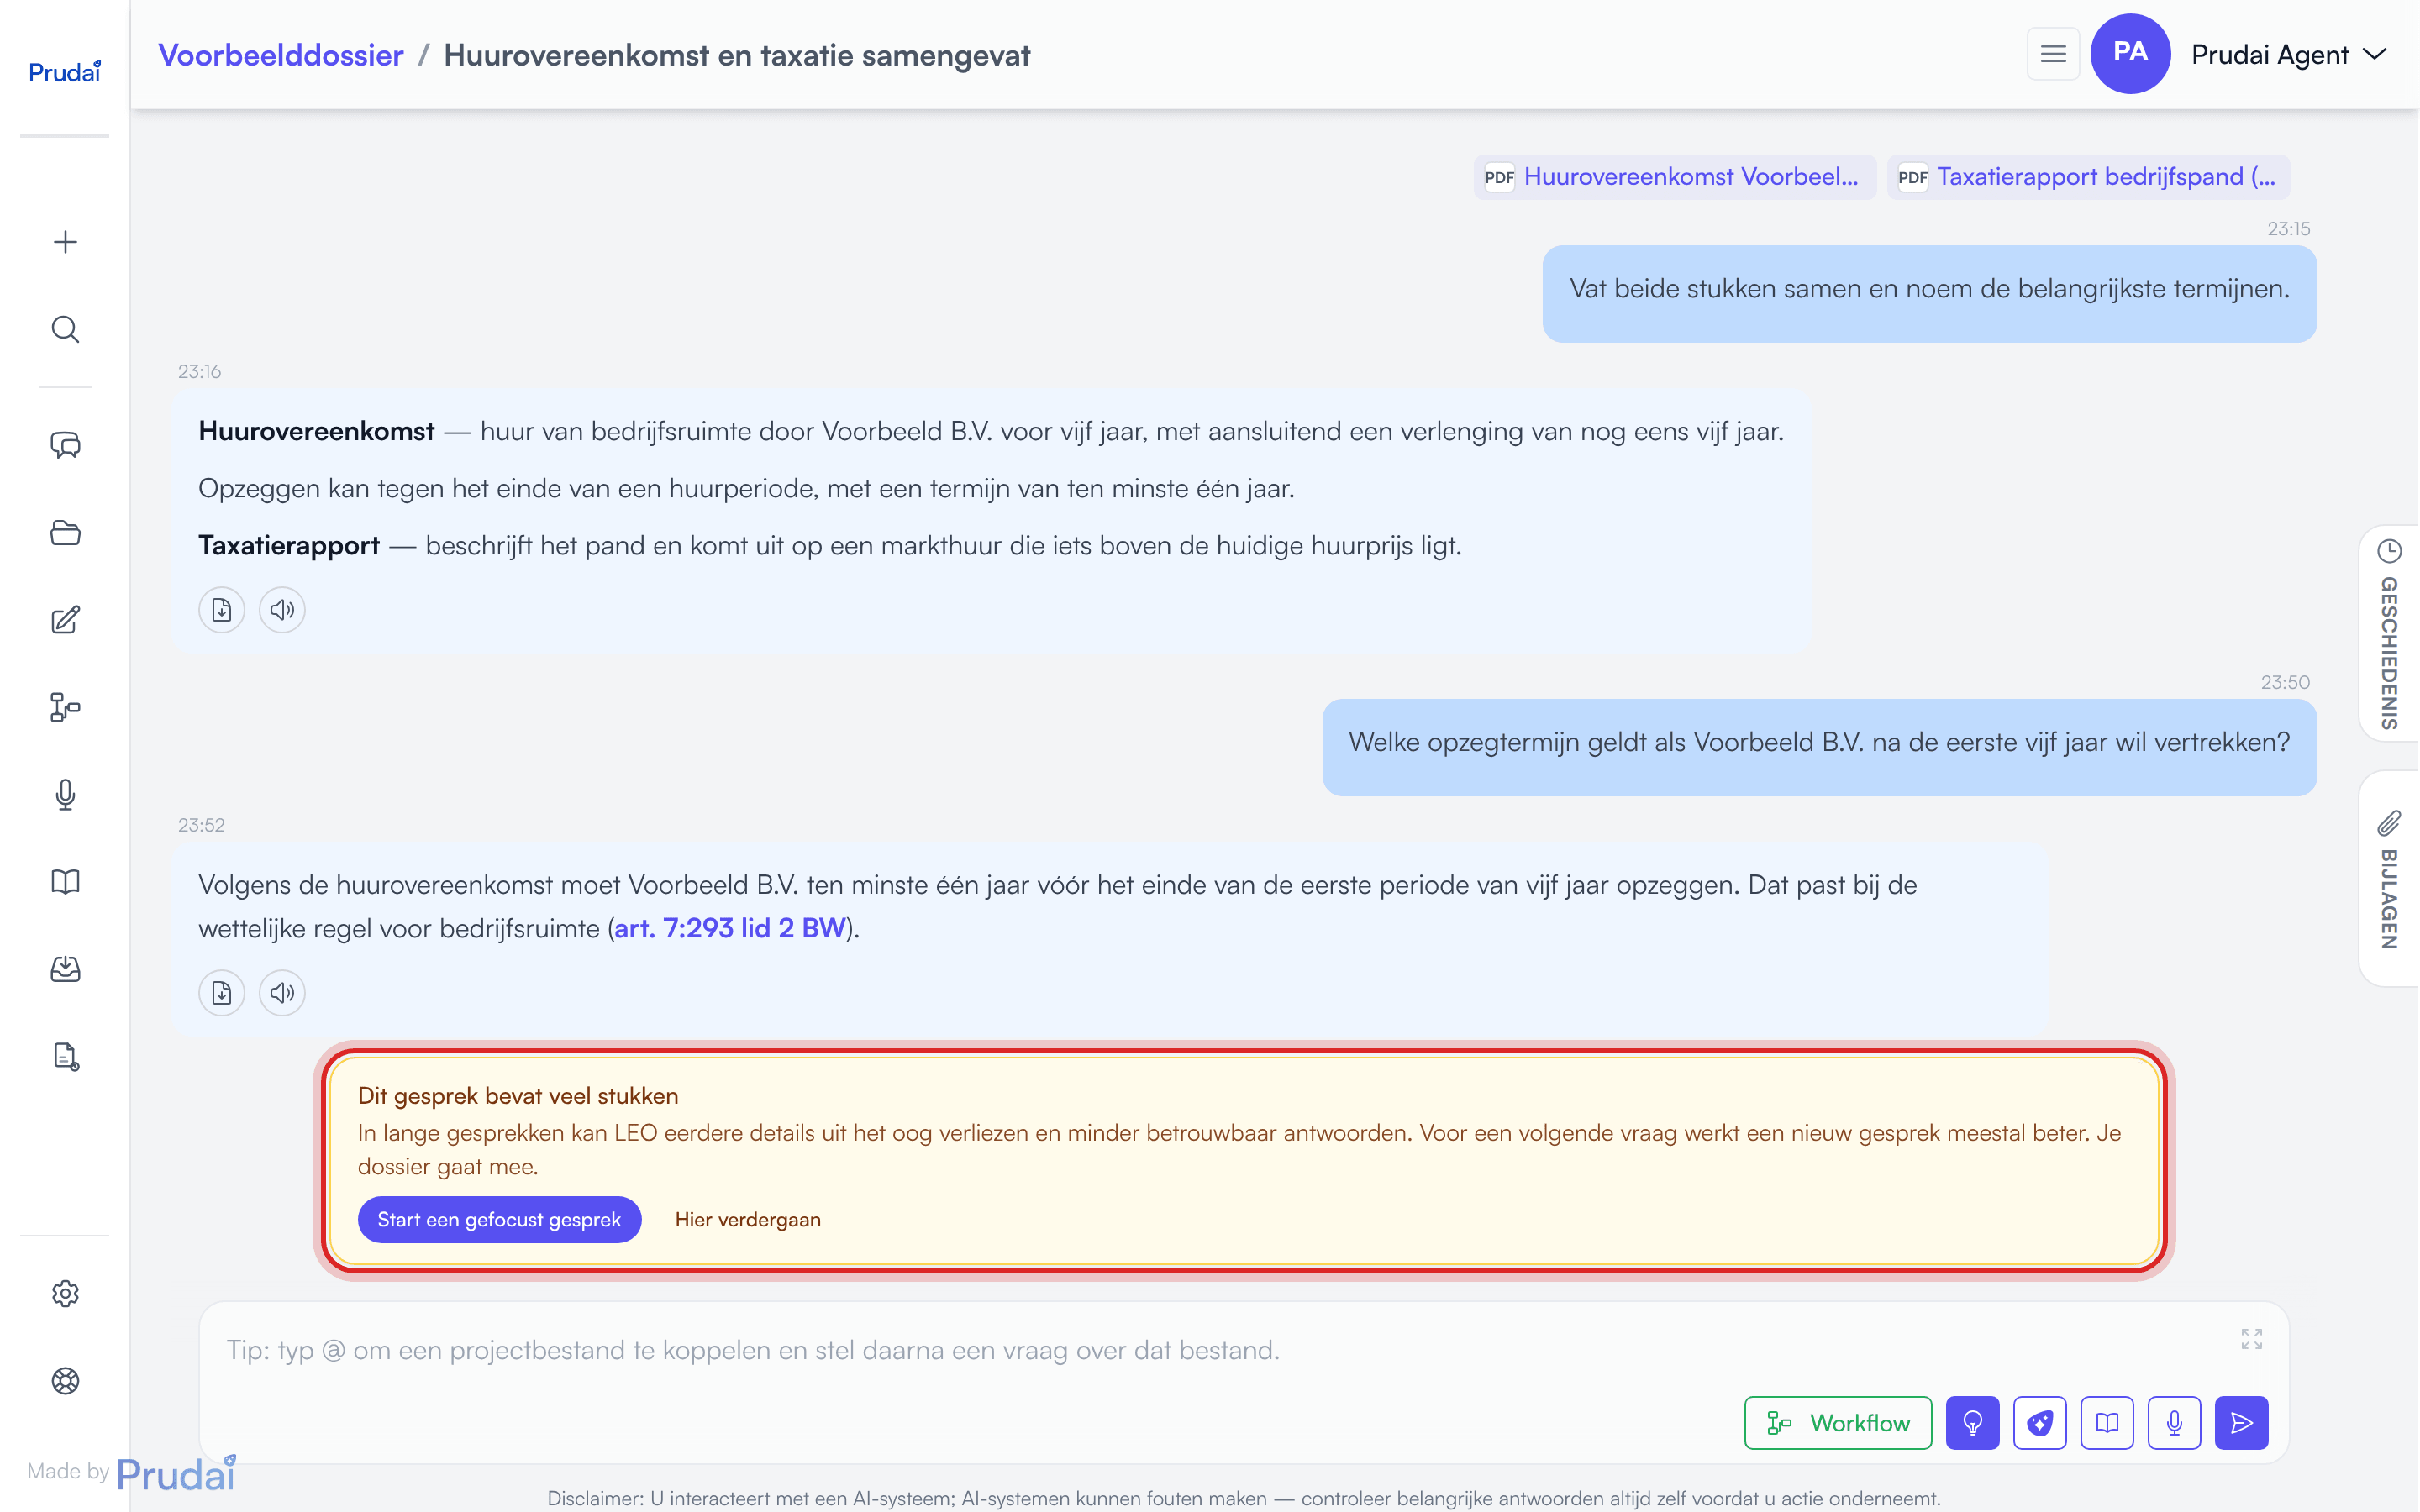
Samenvatten. Grijp je niet in, dan vat de assistent oudere berichten op een gegeven moment zelf samen. Je ziet dan de melding “Gesprek samengevat”. Het antwoord blijft op de hoogte van het volledige gesprek, maar detail uit die oudere berichten kan verloren gaan. Dat is precies het moment dat je liever vóór had willen zijn.
Behandel deze meldingen dus niet als ruis. Ze zijn het signaal om het onderwerp waar je nu mee bezig bent in een verse chat verder te brengen.
Controleer altijd de bron
Section titled “Controleer altijd de bron”Behandel elk antwoord als een concept. Klik in de tekst van het antwoord op de bronpil of het documentcitaat en lees de brontekst zelf na vóór je iets overneemt in je advies of processtuk. Zie je een verwijzing naar een document of passage die je niet herkent? Vertrouw hem niet, start een nieuwe chat en stel de vraag opnieuw met alleen het relevante stuk erbij. Meer hierover: Citaten & bronbeschikbaarheid (inloggen vereist) en Chat.
Dit is ook geen vrijblijvend advies van ons: onder het invoerveld staat daarom een vaste disclaimer dat je met een AI-systeem werkt en belangrijke antwoorden altijd zelf controleert. Zie Chat.
Wat de assistent hoort te doen
Section titled “Wat de assistent hoort te doen”Als de assistent een document niet daadwerkelijk heeft opgehaald, hoort hij dat te zeggen — niet de inhoud ervan te raden. Merk je dat hij toch een passage citeert die niet klopt? Geef het bericht dan een 👎 (Kan beter) met een korte toelichting bij “Wat ging er mis?”. Dat signaal komt bij ons binnen en helpt ons de assistent verder aan te scherpen.
Waarschuwing bij een uitspraak die niet is opgehaald
Section titled “Waarschuwing bij een uitspraak die niet is opgehaald”Voor uitspraken met een ECLI-nummer controleert het platform dit zelf. Noemt de assistent een ECLI dat in het gesprek niet is opgehaald, dan probeert hij die uitspraak eerst alsnog op te halen. Lukt dat niet, dan staat onder het antwoord een waarschuwing:
⚠️ Ongeverifieerde bronvermelding: ECLI-nummer — deze uitspraak is in dit gesprek niet uit rechtspraak.nl opgehaald en door geen enkele bron bevestigd. Controleer de verwijzing voordat je erop vertrouwt.
Gaat het om meer uitspraken, dan heet de kop Ongeverifieerde bronvermeldingen en staan ze allemaal in de lijst.
Een ECLI telt als bevestigd als het voorkomt in een bron die de assistent in dit gesprek heeft opgehaald, in een document dat je hebt toegevoegd of in je eigen bericht. Een eerder antwoord van de assistent telt niet: dat hij het nummer zelf al eens noemde, bewijst niets. Zie je de waarschuwing, zoek de uitspraak dan zelf op voordat je hem gebruikt.
Een stuk laten tegenlezen
Section titled “Een stuk laten tegenlezen”Vraag je LEO om een stuk kritisch te lezen (“lees deze memo tegen”, “geef een second opinion”), dan werkt hij volgens een vaste opbouw. Die opbouw hoort bij LEO; LEO Fiscaal volgt hem niet.
- Eerst het soort stuk en de lezer. Bovenaan staat in één zin welk soort stuk en welke lezer LEO heeft aangenomen, bijvoorbeeld een processtuk voor de rechter of een notitie voor een bestuur. Klopt dat niet, zeg het dan: LEO beoordeelt het stuk naar de maatstaf van dat soort stuk.
- Hooguit drie tot vijf bevindingen: de punten die voor die lezer het meest uitmaken. Elke bevinding sluit af met een voorstel hoe je de passage kunt herformuleren.
- Elke bevinding begint met een label. In de chat staat dat als gekleurd label met een icoon vóór de bevinding:
- Fout: een bron die in dit gesprek is opgehaald, spreekt de stelling rechtstreeks tegen, en LEO vond niets dat de andere kant op wijst. LEO citeert die bron letterlijk.
- Aandachtspunt: vakgenoten kunnen erover verschillen, het hangt van de feiten af, of bronnen wijzen twee kanten op. LEO geeft beide lezingen.
- Suggestie: een optionele verbetering, geen gebrek.
- Voorzichtig geformuleerd is nooit een Fout. Schrijft de auteur “lijkt”, “mogelijk” of “naar mijn inschatting”, dan beoordeelt LEO hoe sterk het argument is, niet of het “juist” is.
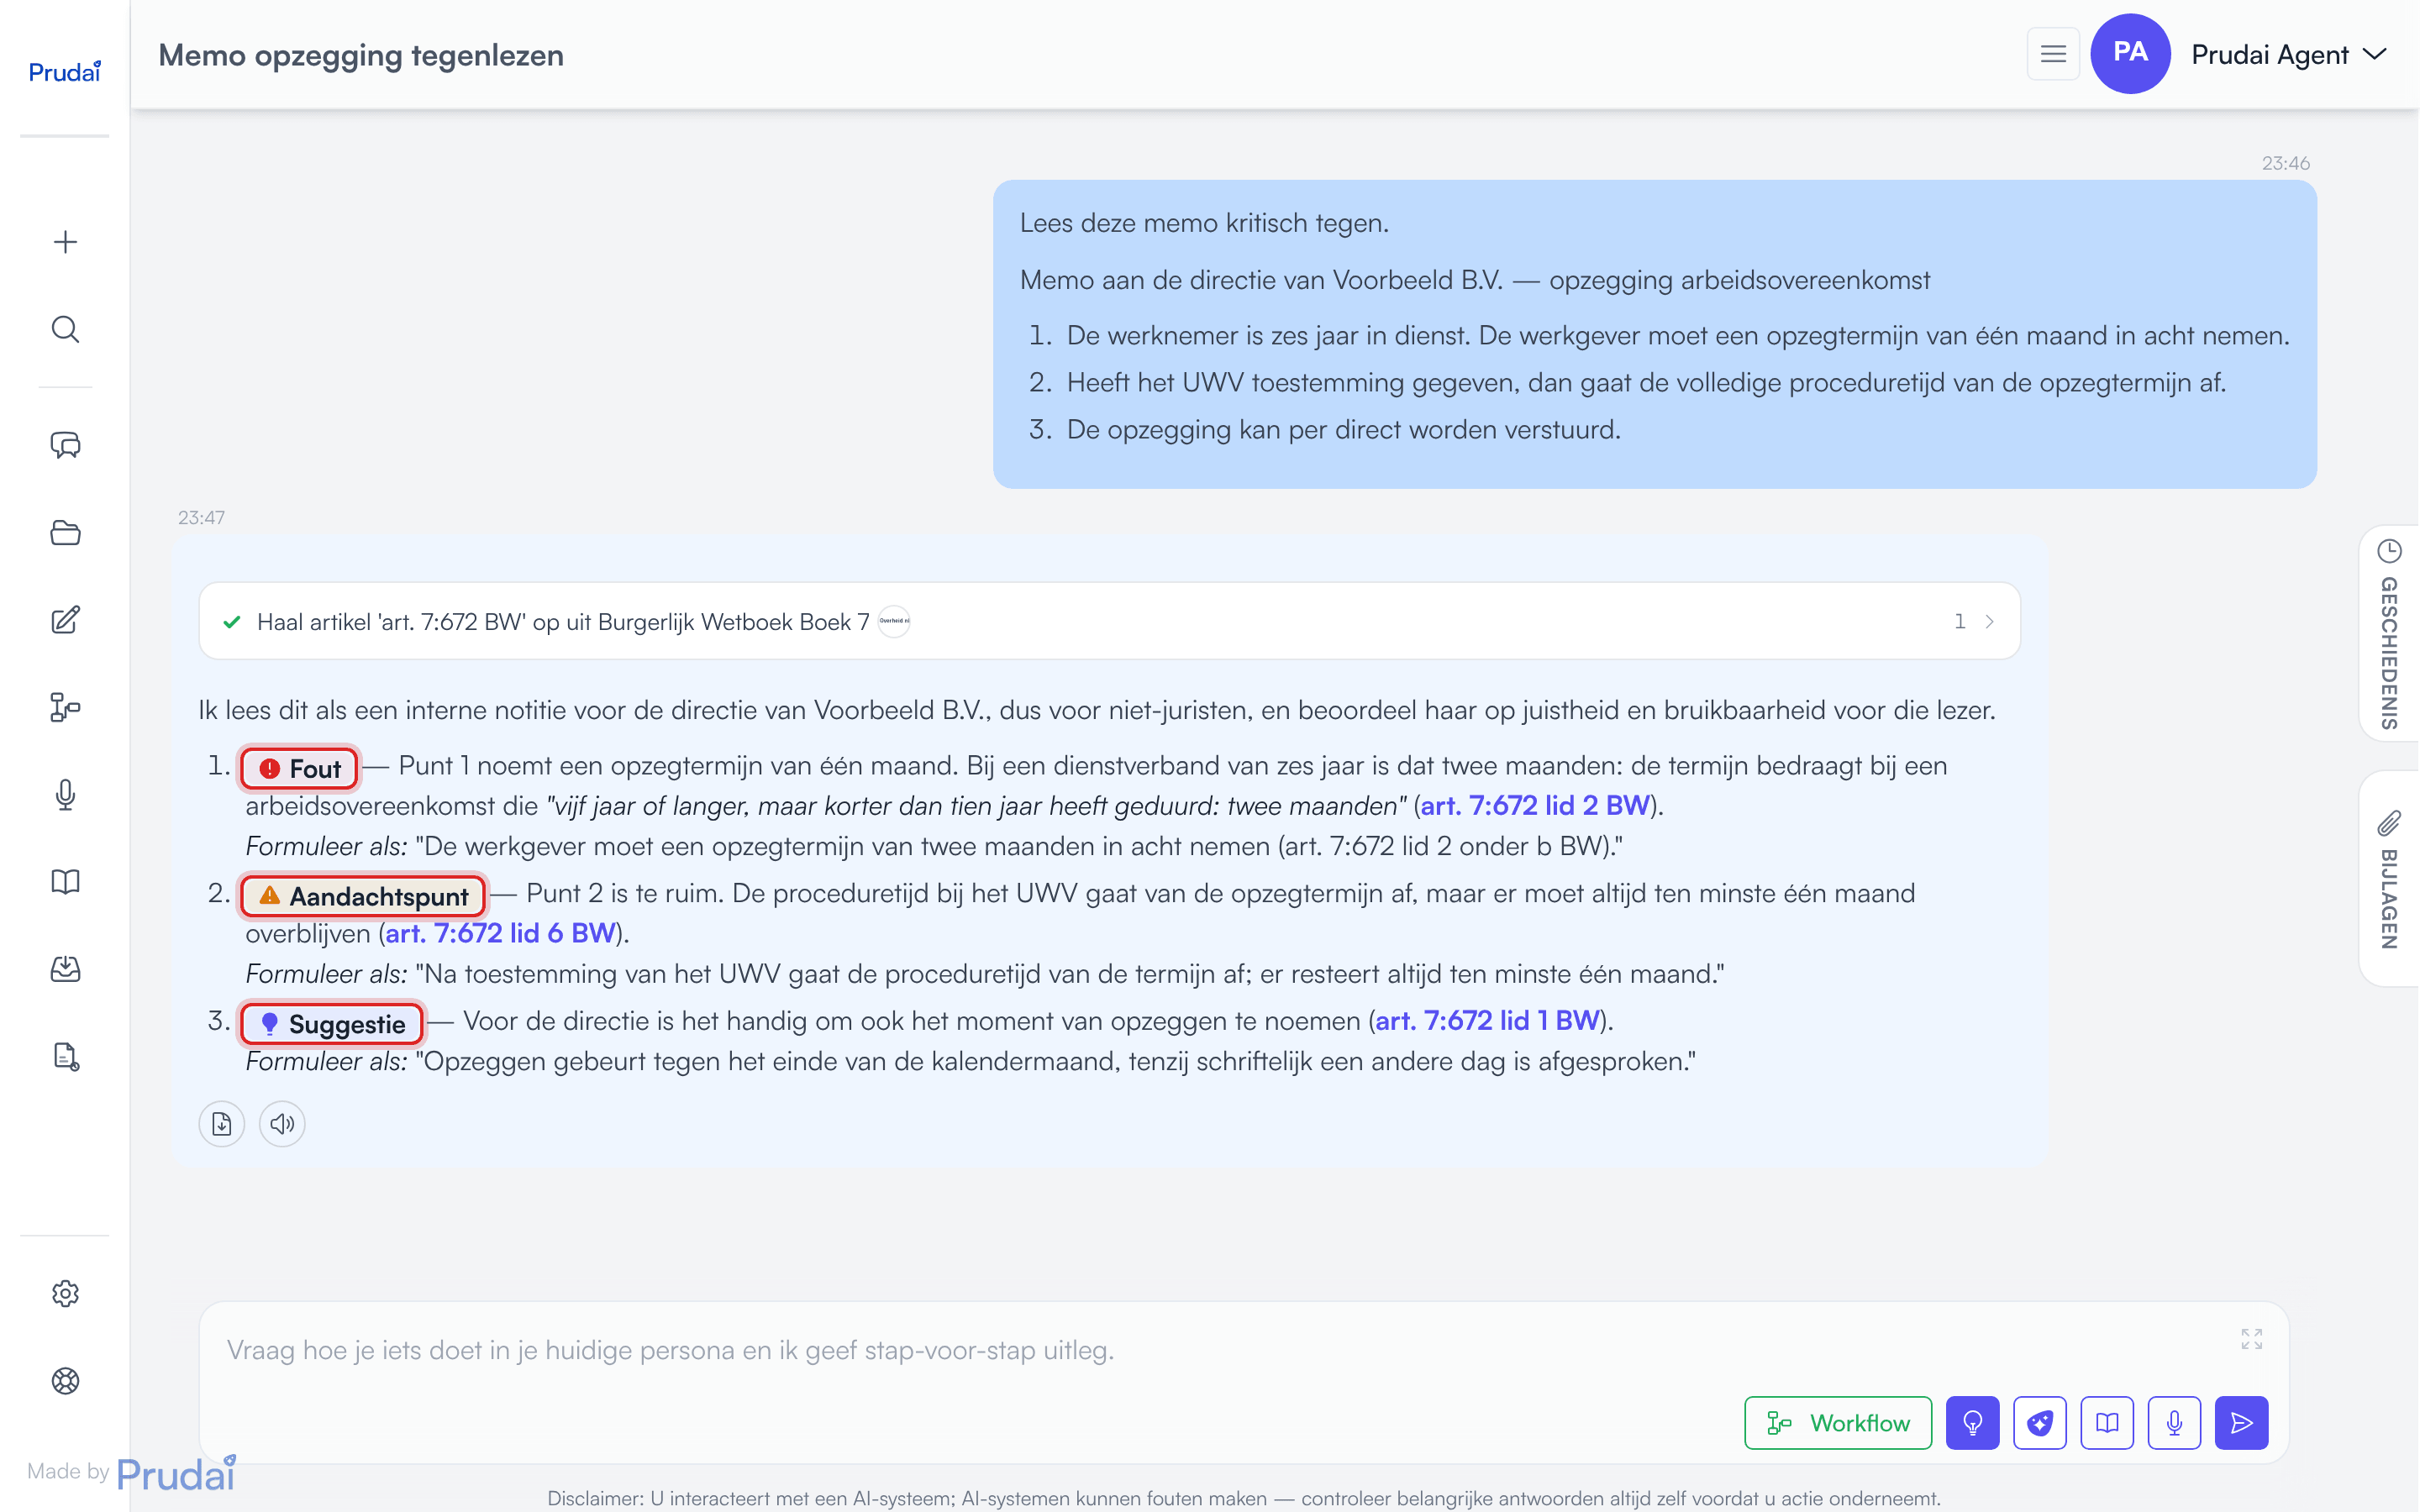
Kopieer of exporteer je het antwoord, dan staat er gewoon het woord, bijvoorbeeld “Fout — …”.
Als een antwoord uitblijft of stilvalt
Section titled “Als een antwoord uitblijft of stilvalt”Een grondig antwoord kan even duren. Duurt het langer dan normaal, dan zie je “Nog even geduld, dit antwoord kost wat meer tijd.” Staat de denkdiepte op Grondig of Ultra, dan krijg je er de tip bij om een lagere stand te kiezen. Schrijft de assistent een lang stuk, zoals een document van duizenden woorden, dan zie je in de bronnenbalk een stap die nog loopt, en valt het antwoord niet halverwege stil.
Komt er te lang niets binnen, dan stopt de chat met een van deze meldingen:
- “Het antwoord duurde te lang om te starten. Probeer het opnieuw.”
- “Het antwoord viel stil. Probeer het opnieuw.”
Stel je vraag dan opnieuw. Gebeurt het bij een grote opdracht vaker, kies dan een lagere denkdiepte of knip de opdracht op in delen. Blijft het misgaan, laat het ons weten via Support.
Herlaad je de pagina terwijl de assistent nog bezig is, dan zie je “Je vorige vraag wordt nog beantwoord”: het antwoord wordt afgemaakt en verschijnt zodra het klaar is.
Wat het onderzoek laat zien
Section titled “Wat het onderzoek laat zien”Dit is geen Prudai-eigenaardigheid maar een breed gedocumenteerd kenmerk van álle huidige AI-modellen:
- Lange invoer wordt minder betrouwbaar. Onafhankelijk onderzoek testte 18 toonaangevende modellen van verschillende aanbieders en vond dat de prestaties stelselmatig teruglopen naarmate de invoer langer wordt — óók bij eenvoudige taken.
- Informatie in het “midden” wordt slechter benut. Modellen gebruiken informatie aan het begin en eind van een lange context beter dan informatie die in het midden verstopt zit.
- Lange gesprekken versterken dit. Over meerdere beurten zakt de nauwkeurigheid gemiddeld met ongeveer 39% vergeleken met één gerichte vraag. Een belangrijke oorzaak: als een model iets mist, “vult” het dat soms in met een aanname en houdt het daar daarna aan vast — precies het patroon dat je wilt voorkomen.
Dit is meteen waaróm “nieuwe chat per onderwerp” werkt: je houdt de context kort, zodat het model niet in dit patroon terechtkomt.
Verder lezen
Section titled “Verder lezen”- Kelly Hong, Anton Troynikov, Jeff Huber — Context Rot: How Increasing Input Tokens Impacts LLM Performance (Chroma, 2025).
- Nelson F. Liu e.a. — Lost in the Middle: How Language Models Use Long Contexts (TACL, 2024).
- Philippe Laban, Hiroaki Hayashi, Yingbo Zhou, Jennifer Neville — LLMs Get Lost in Multi-Turn Conversation (2025).
- Lei Huang e.a. — A Survey on Hallucination in Large Language Models (2023).